全球AI竞争正在发生转变。当大模型参数规模从千亿迈向万亿,当芯片制程逼近物理极限,竞争的焦点已不再仅仅停留于单颗芯片算力或单个模型的榜单成绩——AI竞争博弈,正在向底层软件、技术标准与开发者生态的体系化领域延伸。
底层编程模型、编译框架这类算力底座软件,不仅是开发者工具,更是定义算力如何扩展、如何调度、算法如何运行的规则体系。谁掌握这套标准,谁就掌握产业未来生态的主动权。
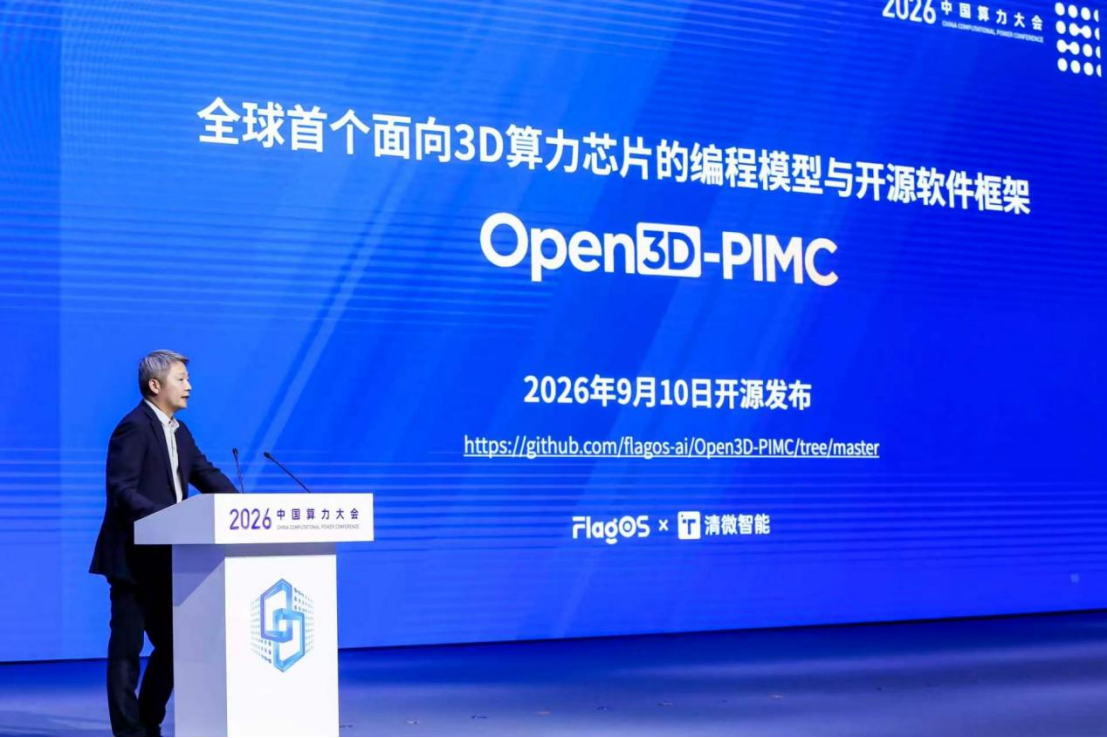
正是在这一关口,全球首个面向3D算力芯片的编程模型与开源软件框架Open3D ‑PIMC在中国算力大会上正式开源发布。该项目由北京清微智能科技股份有限公司与北京智源人工智能研究院联合开发,全部代码已对外上线开源社区,成为国产自主AI软件栈众智FlagOS面向下一代3D算力芯片的主要解决方案之一。
开源:技术博弈的“规则制定权”之争
为何底层基础软件开源建设愈发受到产业重视?答案藏在产业生态协同发展的逻辑之中。海外科技企业在长期发展过程中,既依托成熟的专有软件体系搭建起完整产业生态,配合硬件产品完成技术落地;也通过开放部分工具链汇聚全球开发者资源,持续打磨技术方案,推动相关技术框架逐步成为行业广泛使用的技术范式。一套成熟的编程模型落地之后,会沉淀算法框架、工具库、开发者实践经验等大量配套资源,形成具备高度产业粘性的技术体系。当这套体系获得行业普遍应用,后发硬件产品即便实现性能层面的突破,也需要适配现有成熟的产业技术环境开展商业化落地。
开源已经成为基础软件领域技术演进的主流模式,为产业协同创新提供重要实现路径。依托开源模式,行业主体可以开展跨主体技术协作,加快技术迭代效率,也是国内构建完善计算机技术体系、提升信息技术产业竞争力的重要抓手。中国科学院院士梅宏曾指出,在每一个呈垄断性的软件领域后面,都有对应的开源版本,“抱团取暖一直是对抗已经形成的技术垄断的有效手段,而开源则是抱团取暖的最佳方式。”
软件开源不等于简单代码公开——它是构建自主可控产业生态的战略路径:以开源凝聚产学研力量,避免闭门重复研发,降低全行业创新成本;同时以开放姿态参与全球技术共建,打破海外专有软件生态垄断,掌握技术定义权。
过去几年,我国在AI大模型层面已经涌现DeepSeek、Qwen、GLM等一批有全球影响力的开源成果。但面向下一代新型AI硬件的底层编程软件,仍存在短板。一方面,国内一部分AI芯片厂商的软件生态不得已长期依附在国外软件生态之下。另一部分的国内芯片厂商则是分散建设各自的软件栈,“一芯片一软件栈”的“烟囱式”开发模式导致重复开发、迭代滞后、生态割裂。同一段业务代码要翻译成多套“方言”去运行,研发人员精力耗于底层适配而非算法创新。这不仅让国产算力硬件难以发挥应有性能,更使我国在全球算力规则制定中长期处于被动跟随地位。
缺少自主开源底座,再先进的硬件也难以形成规模产业力量。2026年6月,工业和信息化部明确表示要“提升开源供给能力,加大对基础软件、工业软件、人工智能等领域开源发展的牵引力度”。工信部还提出要“深化全球开源合作,鼓励国内企业深度参与国际开源治理”。Open3D PIMC 开展的开源实践,与这一发展导向相契合,有望为相关领域技术迭代与产业协同提供新的探索路径。
3D算力软件生态:国产算力发展的“下一个高地”
如果说开源是规则之争的战略战场,那么3D算力芯片的软件生态就是这个战场上必须拿下的新高地。
3D算力芯片之所以被视作下一代AI算力迭代的核心方向,根源于后摩尔时代的底层矛盾。随着摩尔定律逼近物理极限,传统二维芯片依靠制程微缩提升性能的路径正遭遇“存储墙”“功耗墙”的硬约束。传统架构芯片面临功耗墙、内存墙、通信墙层层限制,有效晶体管利用率不足40%。3D算力芯片依托三维存算融合技术,将存储单元与计算单元堆叠集成,把数据搬运距离由毫米级压缩至微米级,大幅提升带宽、降低搬运功耗。清微智能的第二代可重构芯片突破性采用3D存算一体与多芯粒合封Chiplet集成技术,将传统芯片2D平面单车道传输模式升级为“算力多车道+多层存储高架”的立体架构。同时,该芯片依托清微多年可重构计算技术积淀,芯片硬件可随AI任务动态重组的特性,突破了芯片灵活性、能耗比、成本这个“不可能三角”的最优平衡。
但硬件架构的突破只是第一步。正如GPU时代有CUDA为开发者提供统一的编程入口,3D算力芯片同样需要一套面向新型硬件架构的编程模型——让开发者用统一的语言接口来开发各种软件应用。没有与之匹配的编程模型和软件框架,再先进的3D芯片也难以释放全部算力潜能。以往,底层基础软件由海外厂商主导,多为闭源专有体系。国内芯片厂商各自为战,在3D芯片这一新兴赛道上同样存在被提前割裂的风险。
Open3D ‑PIMC的出现,正是在这一关键窗口期做出的前瞻性布局。它首次建立了面向3D算力芯片的统一编程模型:开发者仅需定义数据分布、任务划分逻辑,框架自动完成算法向硬件的适配与优化。框架兼容多厂商硬件,各家芯片私有指令集、微架构能力以插件形式保留,兼顾开源共建开放性与企业核心技术权益,从根源上破解了“一芯片一软件栈”的碎片化困境。
更重要的是,Open3D ‑PIMC融入的众智FlagOS生态,已具备了规模化支撑多元算力的实战能力。FlagOS由北京智源人工智能研究院牵头,联合清华、北大、中科院及十余家芯片厂商共建,以“一次开发,多芯运行”为目标。截至目前,FlagOS已实现对20家芯片厂商30多款AI芯片的适配,覆盖GPU、NPU、GPGPU、DSA、RISC-V AI、ARM等多元架构,成为全球支持芯片种类最多的开源AI技术栈。在应用层面,FlagOS实现“一次编写,多芯片运行”,对于主流大模型最新版本,能在一天内完成多芯片同步适配。2026年8月,阿里巴巴发布的超大规模MoE模型Qwen3.8-2.4T-A95B,在发布当天即由FlagOS社区完成了在华为昇腾、沐曦、清微智能等9家AI芯片上的适配验证。这种“Day0多芯片适配”能力,回应了国产AI算力产业化落地的两项核心需求:让云服务与应用生态能够第一时间部署最新模型,让既有算力基础设施持续承接模型演进。“Open3D ‑PIMC填补了国内3D芯片编译器开源项目空白。”北京智源人工智能研究院AI系统研究负责人门春雷表示,随着3D芯片关键技术突破,量产芯片即将陆续出现,但如果缺少配套编译器能力,会造成“先进硬件、低效软件”的困境。Open3D ‑PIMC为3D芯片产业提供了设计参考,通过产业力量的汇聚,加速迭代,形成3D芯片编译器的全球标准,加速3D芯片应用落地。
因此,从更宏观的视角审视,Open3D-PIMC的开源不仅是一次技术发布,更是一次规则的主动定义。在全球AI竞争从性能比拼演进到生态博弈的当下,谁率先建立面向下一代硬件的编程模型与开源生态,谁就掌握了定义技术路线的主动权。国内3D算力芯片硬件层面已有布局——清微智能、华为、小米玄戒等芯片企业的新一代基于3D存算技术的算力产品陆续推出——Open3D-PIMC则在软件层面完成了关键拼图的补齐。清微智能软件副总裁李彬在中国算力大会主旨演讲中表示,清微智能成立八年来,一直践行的“以架构补工艺、以集成超制程、以系统聚算力、以开源创生态”四大场景路径正在从理念走向现实,截至目前清微智能在全国已部署及在建的可重构算力规模超5000P。硬件是“筋骨”,开源软件生态是“血脉”——当筋骨与血脉贯通,国产算力才真正具备了从跟跑到并跑、从并跑到领跑的系统性力量。
代码已开源,生态正生长。据悉,Open3D ‑PIMC开源项目正式发布后,将持续推进编程模型标准化迭代、跨厂商硬件适配与开发者工具完善。今年4季度,项目组将在全球科技顶会发布Open3D ‑PIMC对3D芯片算力的最新优化成果。